Generator wideo, część 7: jak sprawdzam spójność postaci
Dwie osoby wychodzą z piekarni. Jedna podaje drugiej rogalik, oboje się śmieją. Oglądam to już któryś raz i sprawdzam, czy nie zniknęły okulary.
Tak wygląda jeden z moich roboczych eksperymentów w Vini Studio. Z boku może się wydawać, że po prostu generuję urocze kreskówki. Też je lubię. Ale teraz interesuje mnie coś konkretnego: czy postać pozostanie sobą, kiedy obraz zacznie się ruszać.
W piątej części pisałem o obrazach referencyjnych postaci i przedmiotów, a w szóstej pokazywałem, jak powstaje z tego studio. Za tymi zmianami kryje się mniej widoczna praca: wymyślić test, uzyskać wynik i ustalić, co można na jego podstawie powiedzieć. Czasem trzeba skreślić własne wyjaśnienie.
Mira, Bo i jeden rogalik
Do eksperymentu wybrałem dwie dorosłe, fikcyjne postacie. Mira ma rudy warkocz, okrągłe okulary i żółty płaszcz. Bo jest niższy, ma brodę, czerwoną czapkę i zielony sweter. Trudno ich pomylić nawet na małej miniaturze.
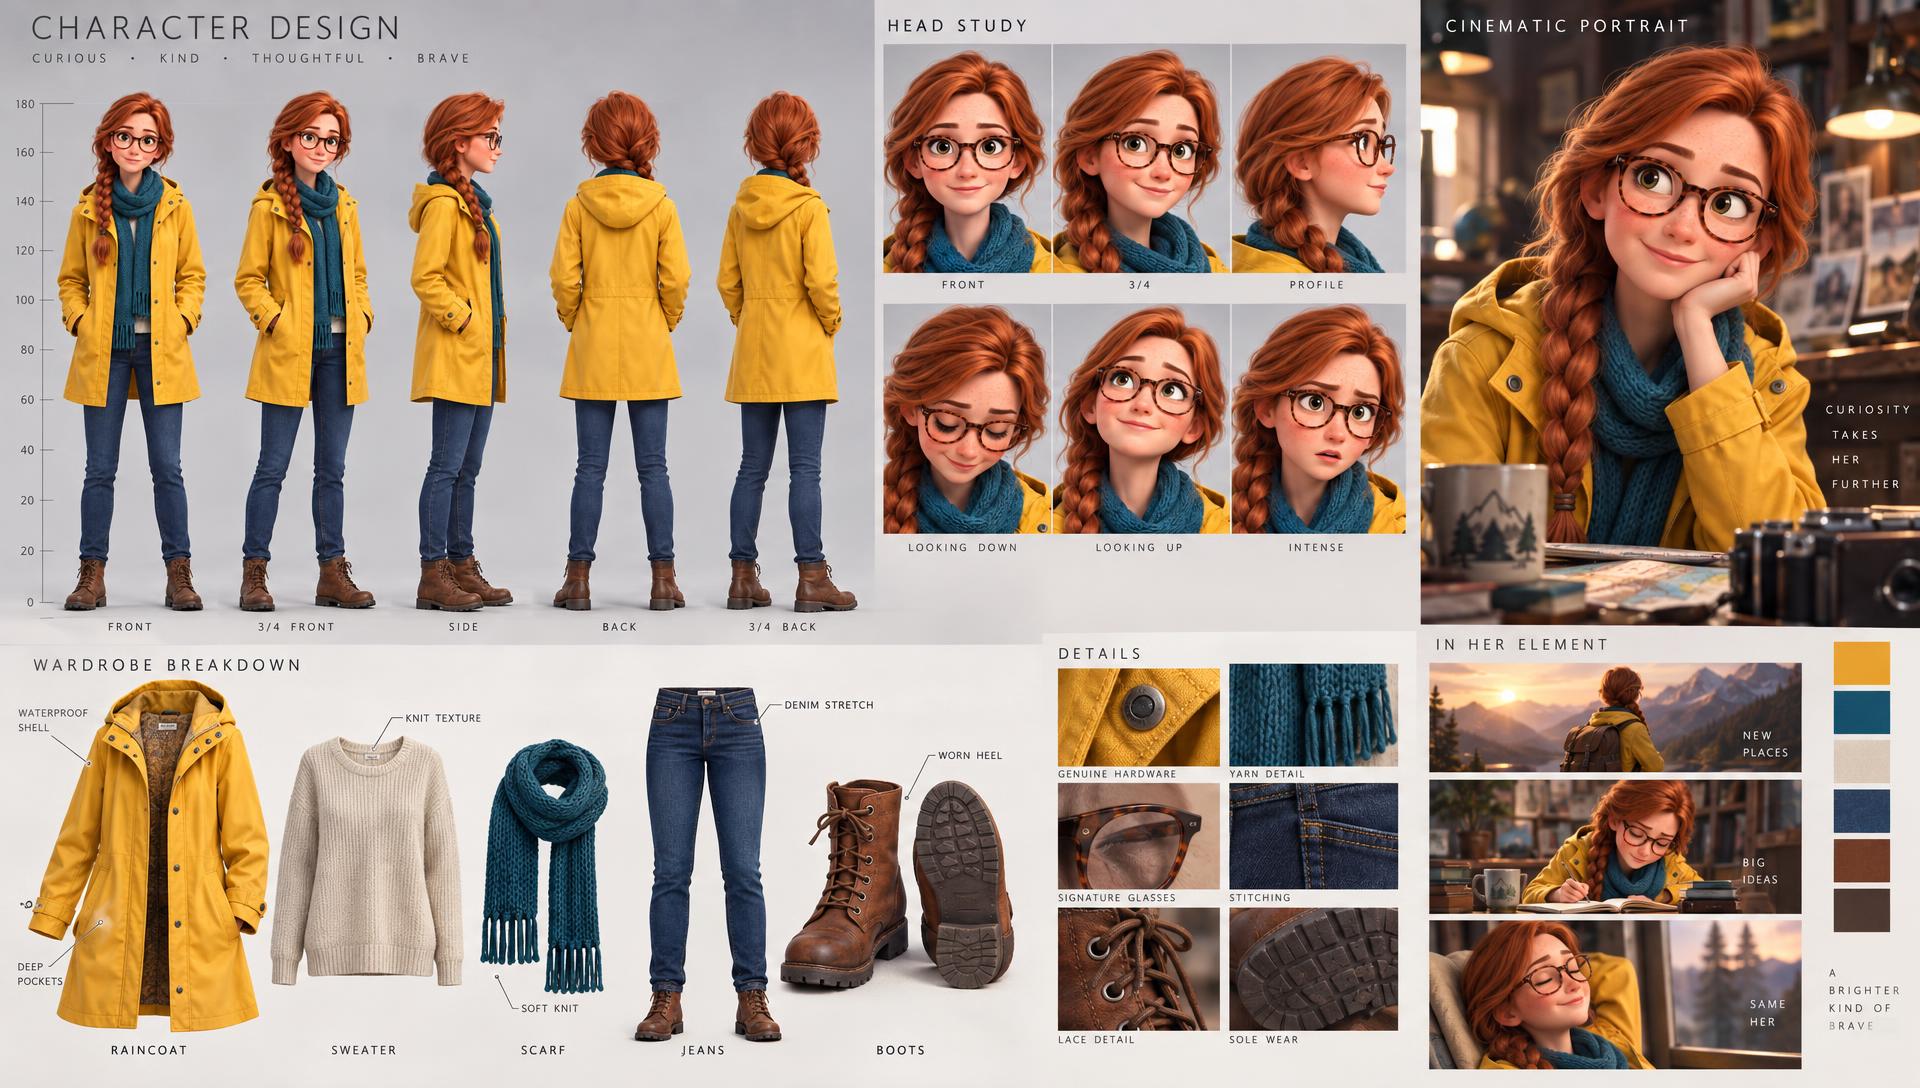
Mira. Na jednej planszy zebrałem widoki i cechy, po których rozpoznaję ją w kolejnych kadrach.
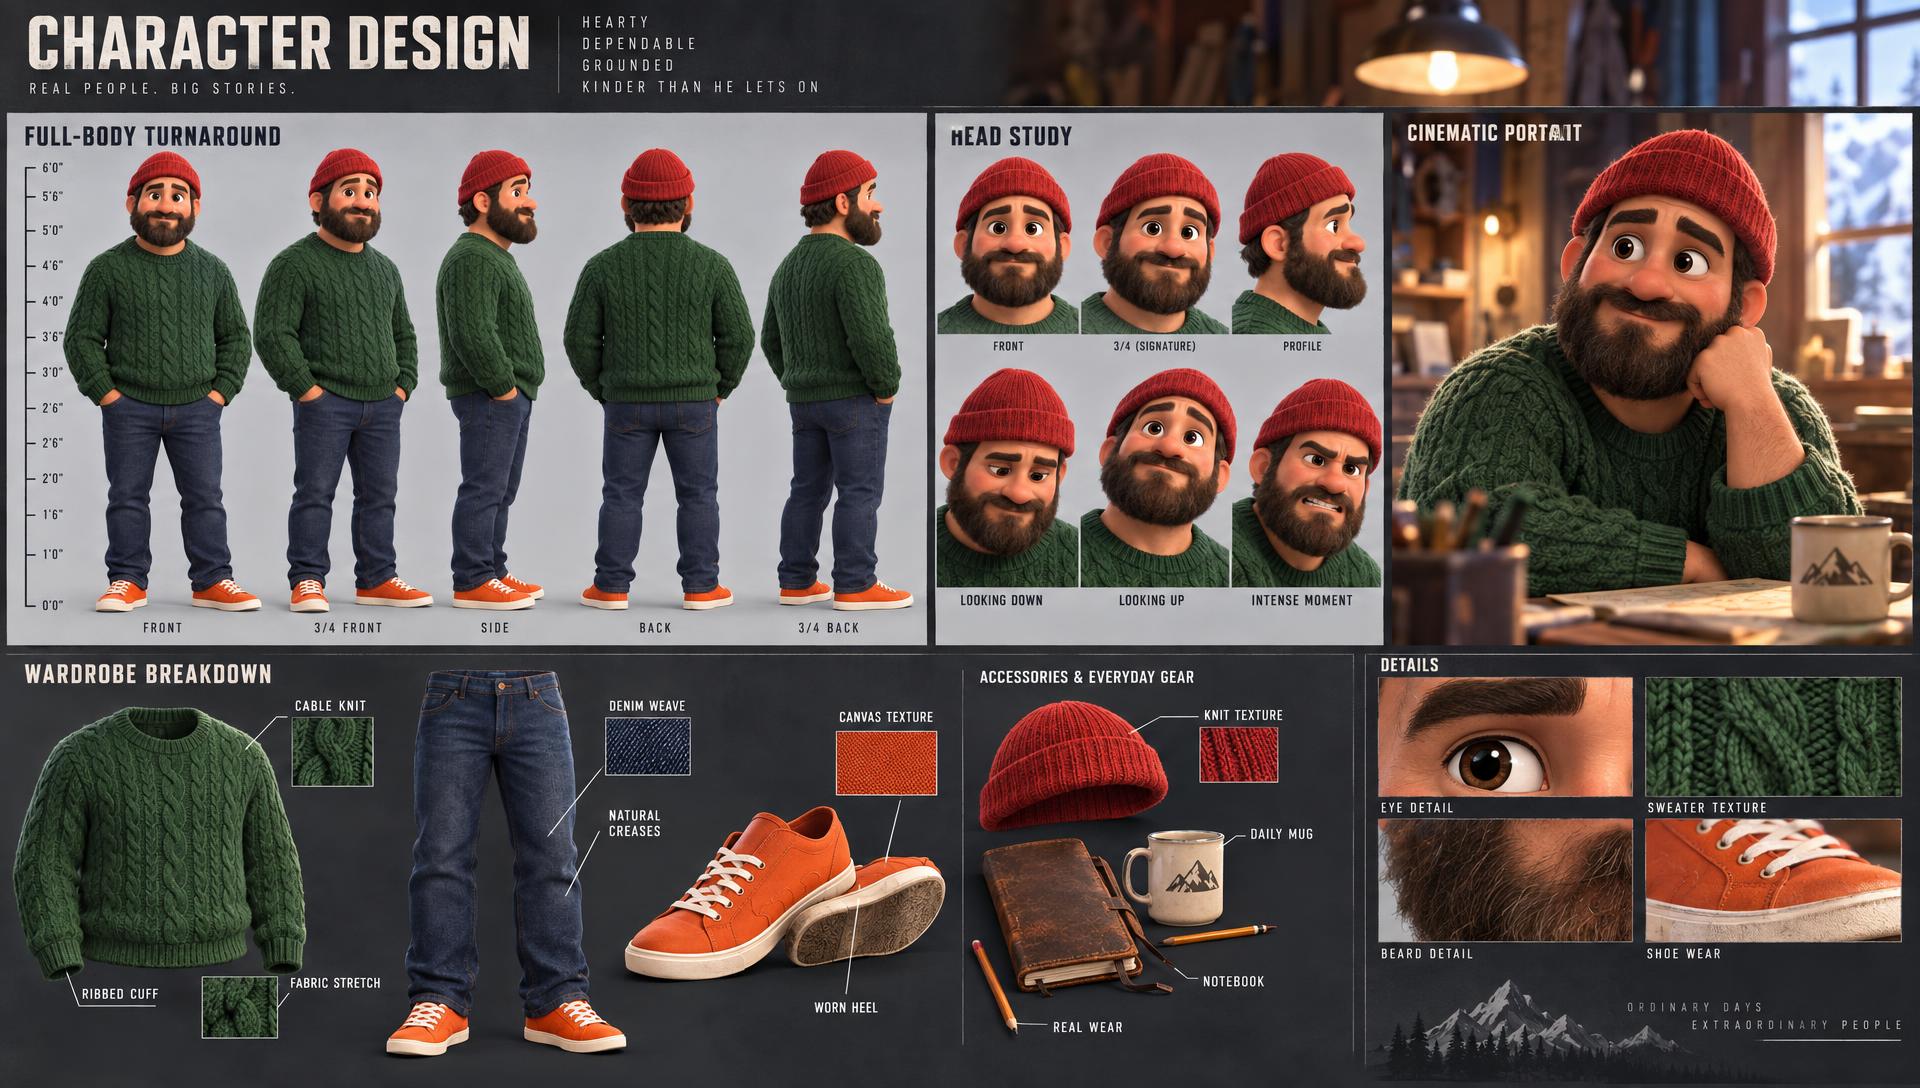
Bo. Pomarańczowe trampki przydają się też w teście: dobrze je widać w planie ogólnym.
Fabuła jest celowo prosta. Chcę zobaczyć, jak bohaterowie idą obok siebie i przekazują sobie przedmiot. Jeśli od razu wyślę ich ratować galaktykę, trudniej będzie ustalić, w którym momencie coś poszło nie tak.
Nawet taka scena musi jednak spełnić kilka warunków. W kadrze mają zostać dokładnie te dwie postacie. Rogalik powinien przejść z jednej ręki do drugiej. Wygląd trzeba zachować w ruchu, nie tylko na pierwszym ładnym kadrze.
Jeden z wyników Gemini Omni Flash. Przyjrzyjcie się bohaterom podczas ruchu i przekazywania rogalika. Warto też zauważyć napisy na piekarni: jeszcze do nich wrócimy.
Najpierw ustalam, co właściwie sprawdzam
„Model dobrze robi wideo” to zbyt ogólne stwierdzenie, żeby na jego podstawie podejmować decyzje w projekcie. Potrzebuję pytania, na które da się odpowiedzieć, oglądając wynik.
Dlatego rozdzieliłem zadania. W jednym eksperymencie bohaterowie mają pojawić się w nowej scenie na podstawie swoich obrazów referencyjnych. W drugim trzeba podmienić postać w gotowym filmie, zachowując to, co dzieje się wokół. Osobno sprawdziłem przygotowanie pierwszego kadru: błąd na tym etapie może przejść dalej do klipu.
To różne testy. Dobry pierwszy kadr nie pokazuje jeszcze, co stanie się z twarzą przy obrocie głowy. A udana podmiana człowieka w gotowym filmie sama w sobie nic nie mówi o tym, jak model wymyśli ruch od zera.
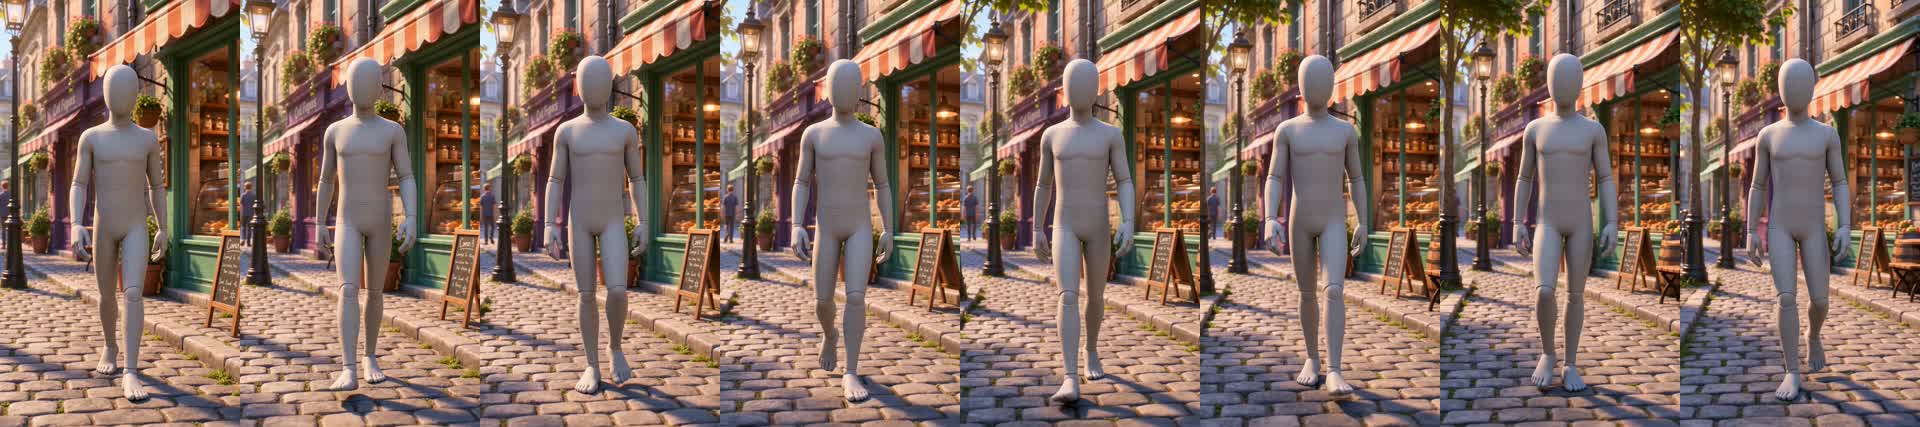
Klip źródłowy do testu podmiany: ulicą idzie manekin. Kadry ułożone są chronologicznie od lewej do prawej.
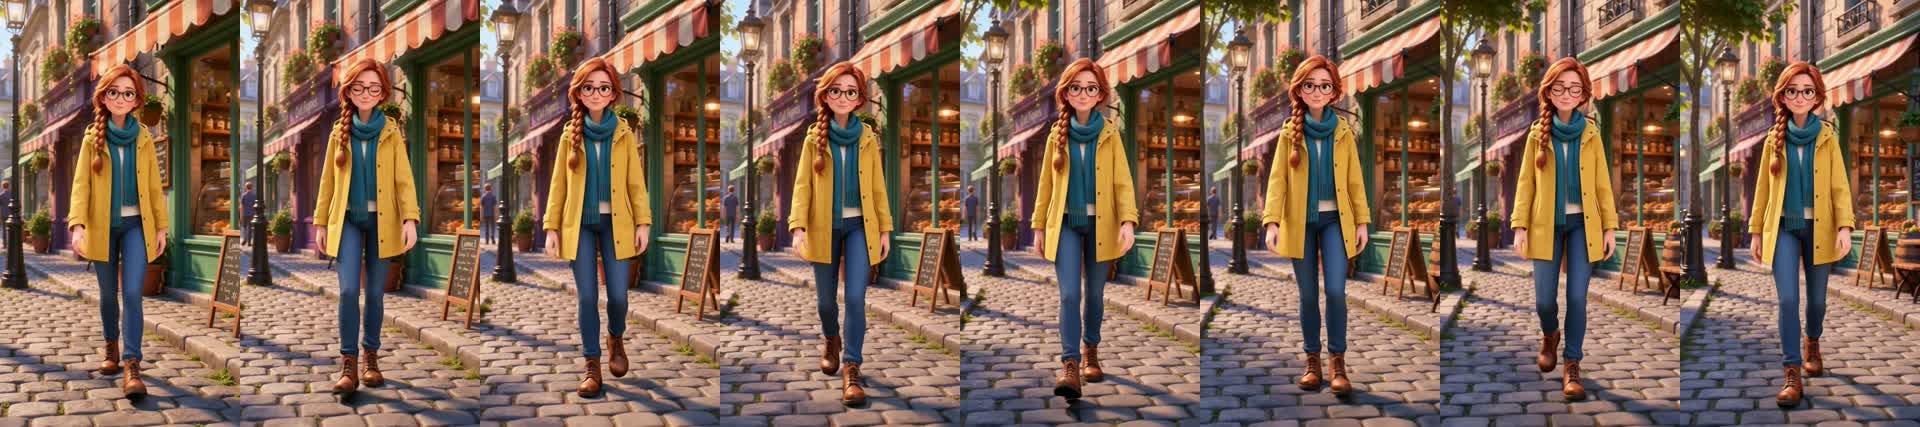
Wynik Kling O3: zamiast manekina idzie Mira. Teraz mogę osobno porównać jej wygląd oraz to, na ile zachowały się ulica i ruch. W tej próbie podmiana się udała: ulica jest rozpoznawalna, a Mira idzie w stronę kamery zgodnie z przebiegiem klipu źródłowego.
Jest tu jeszcze jeden niuans: to samo zadanie nie zawsze oznacza to samo zapytanie. Różne modele przyjmują obrazy na różne sposoby. Sprawdzałem zarówno obecną konfigurację studia, jak i warianty oparte na dokumentacji dostawców modeli. Jeśli naraz zmienia się kilka warunków, taki eksperyment pomaga sprawdzić cały sposób działania, ale nie pozwala przypisać wyniku jednemu trafnemu sformułowaniu.
Co wyszło w różnych modelach
Oto kilka obserwacji z tych prób. Na jednej scenie dobrze widać, jak rozpoznawalność bohatera i wykonanie zadania mogą się ze sobą rozminąć.
Grok i Gemini: bohaterów da się rozpoznać
Grok Imagine 1.5 zachował Mirę i Bo: oboje są rozpoznawalni od pierwszego kadru, a plansze z różnymi ujęciami postaci nie stały się częścią dekoracji. To już dla mnie przydatny wynik. Mogę rozpoznać warkocz Miry, okulary, ubranie Bo, a jednocześnie oglądać zwyczajną scenę pod piekarnią.
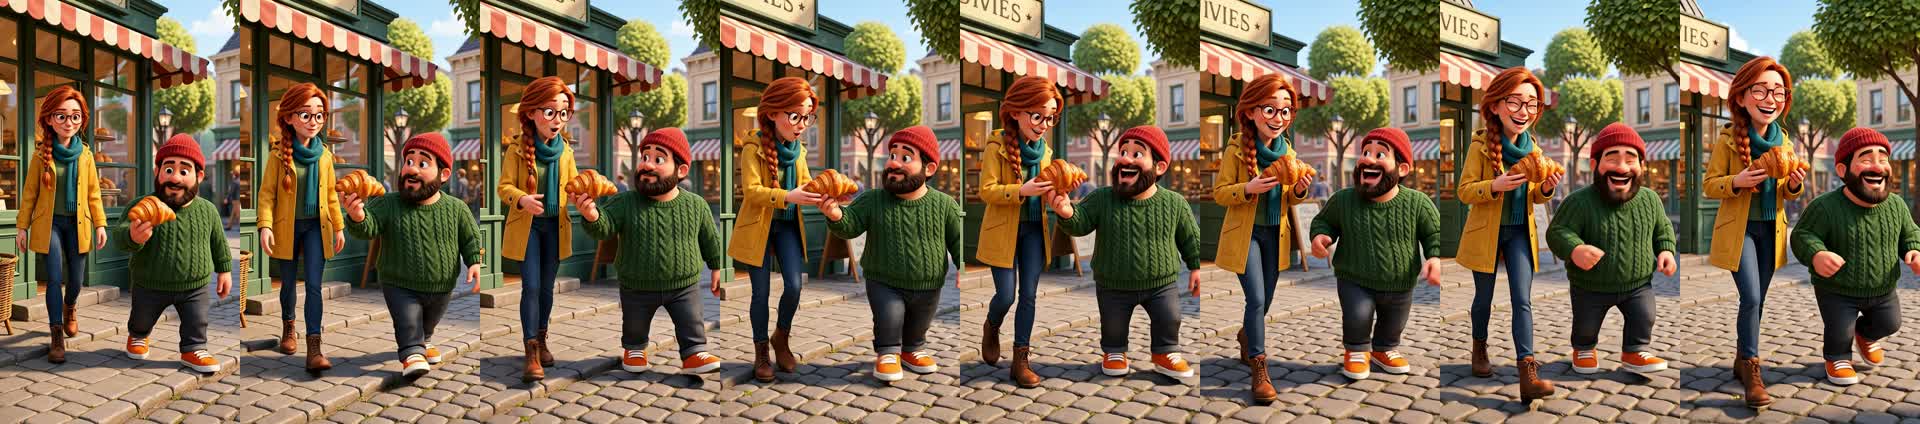
Grok Imagine 1.5. Rogalik trafia do Miry, a bohaterowie pozostają rozpoznawalni przez całą scenę. Model narysował też napis na szyldzie — ten wynik nie spełnił wszystkich warunków zadania.
Gemini Omni Flash również poradził sobie z przekazaniem rogalika w klipie powyżej. Podoba mi się, że mogę tu sprawdzić całą czynność: przedmiot był u Bo, trafił do Miry, oboje zareagowali. Ale napisy na piekarni pojawiły się także w tej wersji. Oba przykłady dobrze zachowały bohaterów, natomiast niespełnione wymaganie dotyczące tekstu na ekranie trzeba było odnotować osobno.
Wan i HappyHorse: kto znalazł się w kadrze
W jednym z wariantów Wan 3.0 Mira i Bo pozostali rozpoznawalni, ale pod koniec kamera zbliżyła się tak bardzo, że przestała mieścić ich w całości. Patrzę na twarze — wszystko znajome. Patrzę na inscenizację — ta już się zmieniła. Gdy przyjrzeć się bliżej, Bo w tych kadrach wygląda też na wyższego od Miry, choć w oryginalnych materiałach referencyjnych jest niższy.
Wan 3.0, jeden z wariantów eksperymentu. Przyjrzyjcie się ostatnim sekundom: Mira i Bo są rozpoznawalni, ale coraz większa część ich sylwetek zostaje poza kadrem.
HappyHorse 1.1 pozwolił sobie na inną drobną swobodę: w jednym klipie Bo jest na początku częściowo zasłonięty drzwiami, w drugim Mira zostaje za drzwiami nieco dłużej. W zwykłej scenie wychodzenie po kolei jest całkiem naturalne. Ale w moim zadaniu oboje mieli być widoczni od samego początku. Taki błąd łatwo przeoczyć, gdy animacja dobrze wygląda.
Seedance: klip się jeszcze nie zaczął, a test już się skończył
Seedance 2.0 Fast i 2.5 odrzuciły kartę Miry: filtr zgłosił, że na obrazie może znajdować się prawdziwa osoba. Mira jest fikcyjna, a karta Bo przeszła kontrolę. Szkoda: chciałem zobaczyć, jak bohaterka się porusza, i nawet do tego nie dotarłem.
Przy innych wariantach obrazów wejściowych oba modele wygenerowały klipy z rozpoznawalnymi bohaterami. Dlatego odmowę zapisuję osobno od jakości generowania. Pokazuje problem z przyjęciem konkretnego materiału; w nieistniejącym klipie nie ma ruchu, który można by ocenić.
Rozpoznawalna postać to za mało
W pierwszych wynikach sporo mi się podobało: bohaterowie są rozpoznawalni, ubrania podobne, scena wygląda żywo. Łatwo odhaczyć temat i przejść dalej.
Ale oto osobny wynik przygotowania pierwszego kadru w Nano Banana 2:
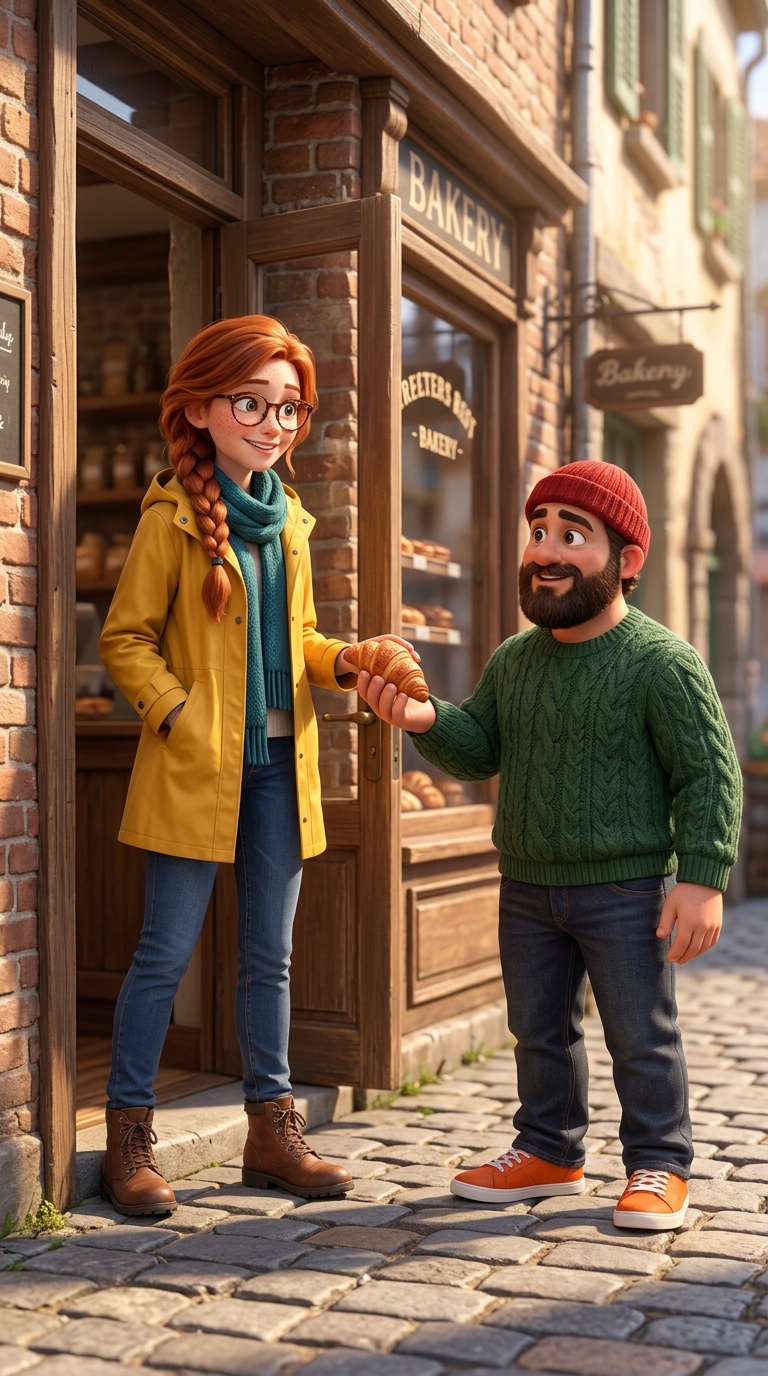
Nano Banana 2. Bohaterowie są na miejscu. Napisy też, choć polecenie zabraniało ich rysowania. Rozpoznawalność postaci i przestrzeganie ograniczeń dały tu różne wyniki.
Sam lubię ten obrazek. Właśnie dlatego warto z góry zapisać, co chcę sprawdzić. Inaczej po wygenerowaniu łatwo uznać, że szyldy nawet dodają scenie uroku, i niepostrzeżenie dopasować kryterium do wyniku, który mi się spodobał.
A oto pierwszy kadr z innej próby, w GPT Image 2.5:
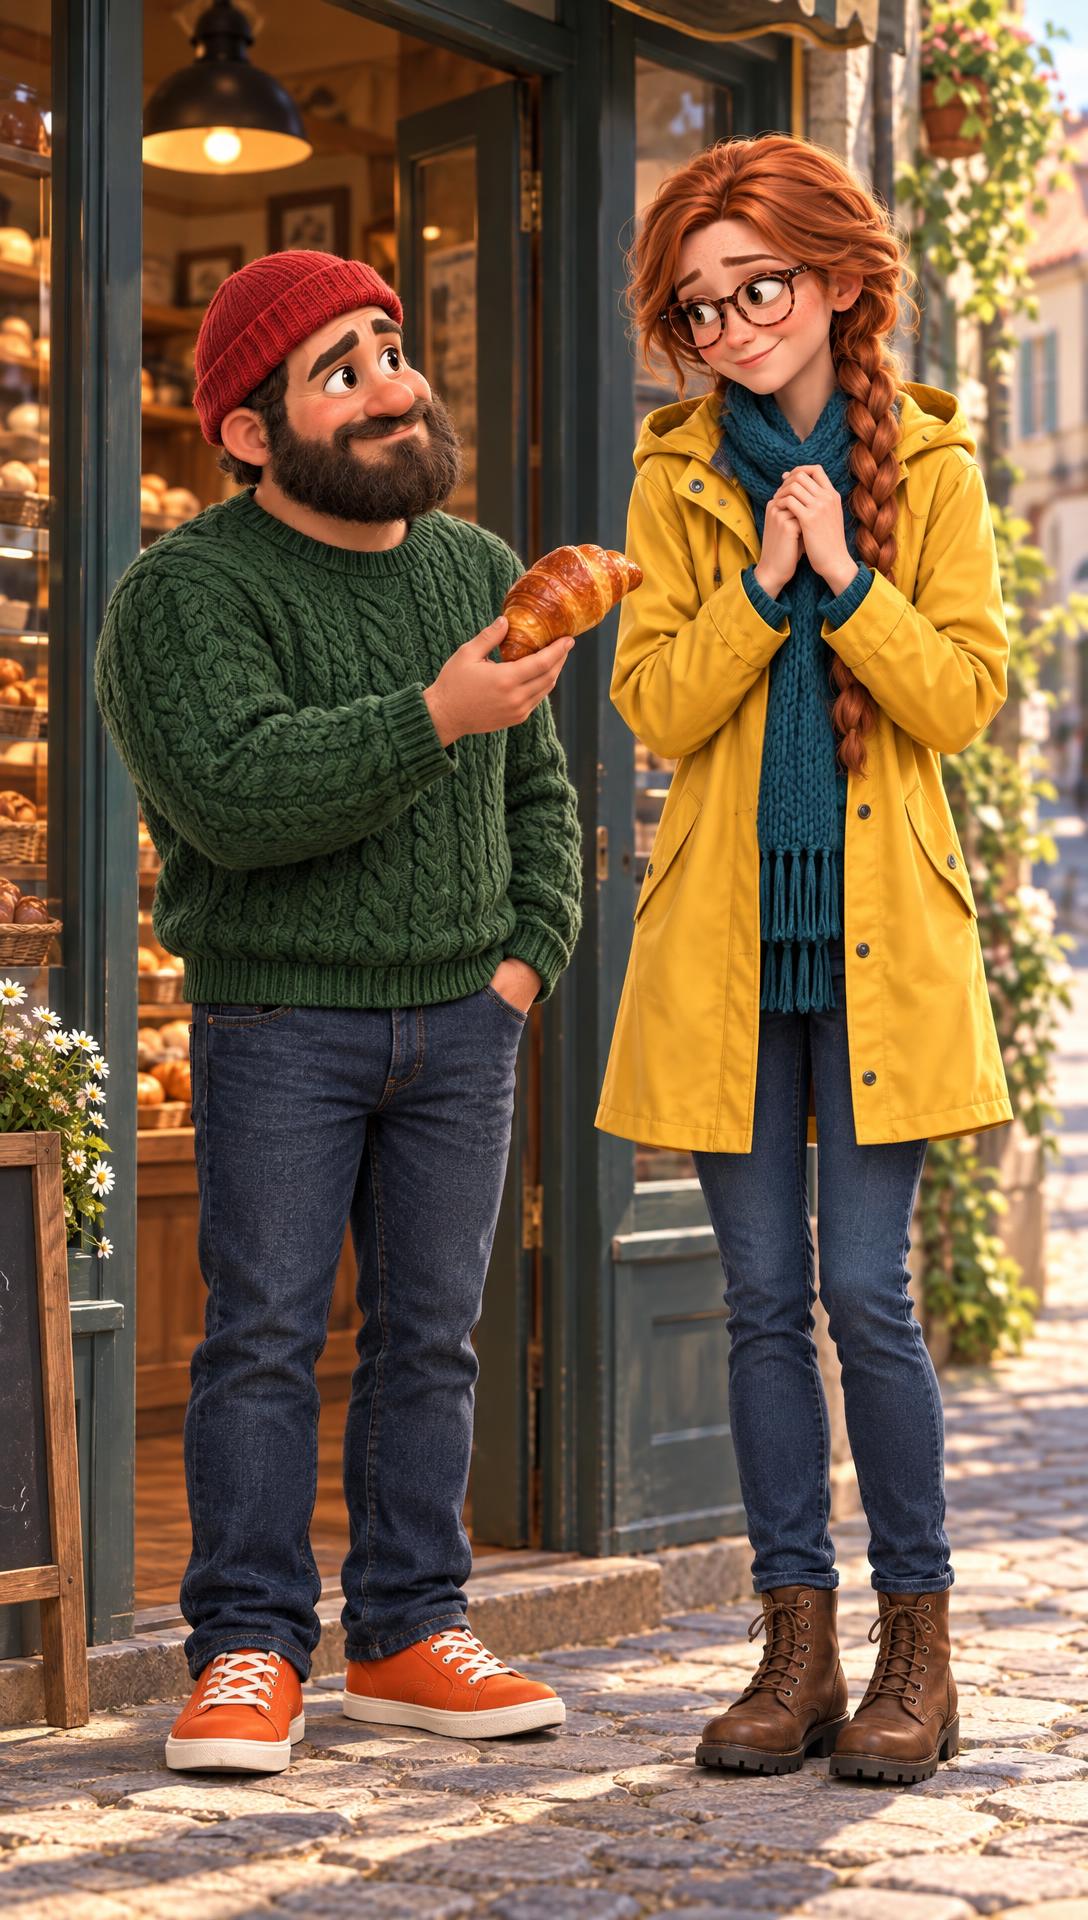
GPT Image 2.5. Bohaterowie stoją inaczej: Bo po lewej, Mira po prawej. W tym wariancie zadania nie określiłem stron, więc nie uważam takiej zamiany za błąd.
Lubię to zestawienie także jako sprawdzian własnej oceny. Napis, którego zabroniłem, narusza polecenie. Ustawienia postaci, które tylko sobie wyobraziłem, ale którego nie podałem, model nie ma obowiązku zgadywać. Jeśli pomieszam te rzeczy, porównanie szybko zmieni się w konkurs zgodności z obrazkiem w mojej głowie.
Badacze stosują podobny podział w VBench: niezmienność wyglądu bohatera, płynność i intensywność ruchu ocenia się osobno. Moje przykłady nie były oceniane tym benchmarkiem; przydaje mi się tutaj samo sformułowanie problemu.
Istnieje też odwrotna pułapka. Można tak skupić się na zachowaniu wyglądu, że przestaje się zauważać słaby ruch. W pracy ConsistI2V autorzy zaznaczają, że ich metoda czasem daje ruch o niewielkiej amplitudzie. To ograniczenie konkretnej metody, ale dobry powód, żeby patrzeć również na akcję, gdy sprawdzam, czy bohater pozostaje sobą. W mojej scenie nie wystarczy zachować okulary Miry. Rogalik musi przecież zmienić właściciela.
Najbardziej przydaje się moment, gdy hipoteza się nie potwierdza
W uporządkowanej scenie testowej z Mirą i Bo wiele rzeczy działało. Tymczasem w roboczym projekcie pojawiały się wcześniej zupełnie inne wyniki: obrazy referencyjne zmieniały się we wstawki w filmie, przybywało dodatkowych postaci. Kusiło mnie, żeby uznać to za przypadkową, nieudaną generację.
Spróbowałem odtworzyć błąd. Na testowych postaciach pojedyncze zmiany warunków go nie przywróciły. Za to po ponowieniu zapytania z roboczego projektu, z jego oryginalnymi materiałami, charakterystyczne błędy wróciły. Warunki nie pokrywały się w pełni: w jednej z prób użyłem innej rozdzielczości. Miałem już jednak przykład, na którym mogłem sprawdzać wyjaśnienia.
Pierwsze wyjaśnienie brzmiało przekonująco: problem tkwi w obrazach źródłowych. Potem zmieniłem sposób ich podania i dostałem niewygodną odpowiedź. Część usterek zniknęła, inne zostały albo ustąpiły miejsca nowym. Za wcześnie uznałem, że już rozumiem.
Kolejne eksperymenty pokazały, że trzeba uwzględnić zarówno opis sceny, jak i obrazy wejściowe. Ich połączenie okazało się ważniejsze, niż zakładało pierwsze wyjaśnienie. Ważny jest dla mnie moment, w którym następny test zmusił mnie do zmiany wniosku.
Tak rozumiem naukowe podejście w swojej pracy. Najpierw jest obserwacja i przypuszczalna przyczyna. Potem trzeba wymyślić eksperyment, w którym to wyjaśnienie może się nie sprawdzić, i naprawdę go przeprowadzić. Niewygodny wynik też zostaje w notatkach.
Staram się zmieniać po jednym warunku tam, gdzie to możliwe. Kiedy zmieniam kilka naraz, zaznaczam to osobno. Nawet staranne porównanie pojedynczych generacji traktuję jako wskazówkę do następnego eksperymentu: losowość nigdzie nie znika.
Czego ten test jeszcze nie dowodzi
W głównej macierzy na każdą kombinację warunków przypadało jedno uruchomienie. To wystarczyło, żeby zobaczyć działające warianty i znaleźć problemy do dalszego zbadania. Nie da się tak zmierzyć częstości błędów.
Jeśli raz udało się zachować postać, wiem, że taki wynik był możliwy. Nie wiem jeszcze, ilu prób będę potrzebował w następnym projekcie. Nawet powtarzający się błąd nie uprawnia do stwierdzenia, że model nie nadaje się do żadnej sceny.
Poza tym główny test dotyczył stylizowanych dorosłych postaci i krótkich scen. Części wariantów nie uruchomiłem. Wnioski dotyczące długiego odcinka albo innego stylu wizualnego będą wymagały osobnych przykładów i powtórzeń.
W kolejnym etapie potrzebuję serii uruchomień na kilku scenach. Chcę zrozumieć, jak często trzeba poprawiać wynik i które błędy wracają po zmianach. Obrazki w tym artykule pokazują, co wyszło w pojedynczych eksperymentach; ocena niezawodności jest jeszcze przede mną.
Co z tego trafia do studia
Takie testy już pomagają w rozwoju produktu. Po nich lepiej wiem, gdzie szukać problemu i na jakim przykładzie sprawdzić przyszłą poprawkę. Czasem okazuje się, że trzeba dokładniej opisać zadanie. Innym razem muszę ustalić, jak studio przekazało materiały modelowi. Samo przełączenie na inny model nie rozwiązuje tej kwestii.
W pierwszej części cyklu podobnie sprawdzałem scenarzystę. Teraz zamiast tekstu mam przed sobą bohaterów z rogalikiem, ale nawyk został ten sam: zapisać dane wejściowe i wynik, żeby później móc wrócić do własnego wniosku i go sprawdzić.
Podoba mi się, że po tej pracy zostają też takie obrazki. Mogę oglądać Bo po prostu dlatego, że jest sympatyczny. A potem jeszcze raz włączyć klip i zauważyć błąd, który umknął mi przy pierwszym wrażeniu.